CSSのhue-rotateは正しい色相変換をしない。これはMDNのドキュメントにも書かれていることで、
hue-rotate()は RGB 色に対する行列演算として定義されています。これは実際には色を HSL モデルに変換するものではなく、非線形操作です。そのため、特に彩度の高い色の場合、元の色の彩度や明度が維持されない場合があります。
とある。HSLモデル(色空間)は彩度と明度を保ちつつ色相を回転させることができる優れたモデルであり、その変換式はWikipediaのものや、Pythonの標準ライブラリに見ることができる。精度が求められる箇所ではこれらの定義に基づく色変換をすることで誤差を小さくできるが、一方で、これら正確な色変換は高速に処理できないという欠点がある。変数除算1がある上に、複数の入力を受け取ることができないのだ。
そのため、CSSのhue-rotateでは行列演算を採用しているが、これは近似的な処理をするものなので、HSLモデルによる色相変換のような精度はない。以下に実際にプロットしたものを示す。
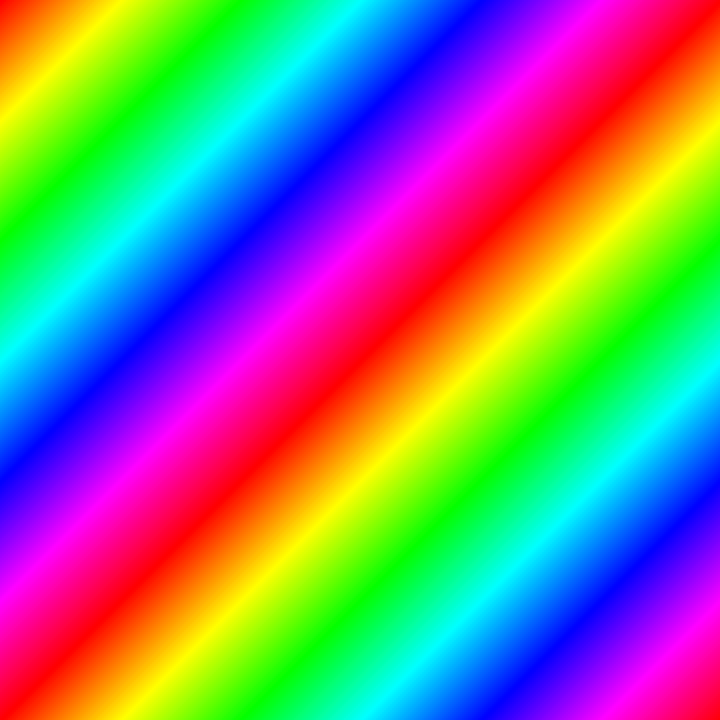
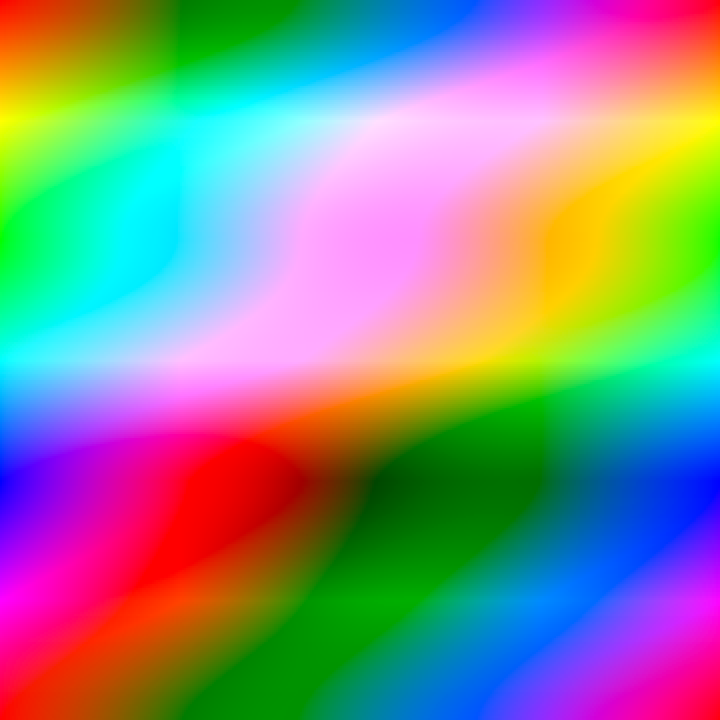
そんなバナナ!
両画像とも第1列(縦方向)に赤(0°, 1.0, 0.5)の原色から1°ずつ色相を回転させたものを並べている。左(スマホレイアウトなら上)の画像は第1列から右方向にHSLモデルで色相を1°ずつ回転させて、右(下)の画像はCSSのhue-rotateで色相を1°ずつ回転させたものである。見てわかるように、hue-rotateによる色相変換は結果にゆらぎがある上に、結果が元となる色の明るさに強く影響されている。
それであっても行列演算を使うのは高速であるからだ。最初に簡単な例を示すが、座標の並行移動に関しては次のような行列を使用する(アフィン変換と呼ぶ)2。
この行列演算は座標 を に変換するもので、実際に計算すると、
となる。行列計算の特徴として、変換したい複数の座標があれば、複数のベクトルからなる行列を入力することもできて、その場合には、
とできる。さらに素晴らしいのは行列の乗算は、加算、減算(これは負数の加算として処理される)、乗算の組み合わせだけで処理することができ、除算が表れないことだ。
さて、hue-rotateに話を戻すと、WebKitの実装では次のような行列が与えられている。元の定義はW3Cにあり、これに沿ったものとなっている。
ここで入力はRGBモデルの画素値 を期待している。通常コンピュータ上の色は光の三原色に基づいてRGBモデルで指定することが多いが、色相変換についてはHSLモデル上で色相を回転させることを期待している。
つまり、RGBモデルの色を色相変換するにはまずHSLモデルに変換して、色相を変換したのちにRGBに戻すという手間があるが、hue-rotateのような近似的な行列演算では、直接RGBモデルから色相変換したRGBモデルに変換でき、それも行列演算によって複数のデータを一度に処理できるようになっていることが強みとなっている。そのためなら多少の差(非線形操作)は許容してもいいものではないだろうか。
除算って遅いの?
除算は定数除算と変数除算の場合に分けることができる。定数の場合は割る数があらかじめわかっているので、割る数が であればビットシフトに置き換えることができるし、そうでない場合にはハッカーのたのしみでも触れられているように、マジックナンバーを使った計算をする。通常はコンパイラやインタープリタが最適な除算方法を選択するのでプログラマが考慮する必要はないが、今回は試しに内部的にどういうことが行われているのかを確認してみる。
一方で変数除算はどういった数がくるのかわからないので、こうした最適化ができず、プロセッサの除算命令に頼るしかなくなる。例えばARMv7の除算命令は2-12サイクルかかるし、uops.infoのIDIVによれば最新世代のIntelプロセッサでは除算性能が向上しているものの、それでも10クロック以上かかることがわかる。
マジックナンバーを使った除算
マジックナンバーを使った除算の一例を示す。手元のマシン(ARM64)で
int main() {
    printf("%d\n", rand() / 3);
    return 0;
}
をgcc (clang)でコンパイルしたのちにobjdumpすると次のアセンブラのコードが生成できる。最適化オプションをつけないと同じような結果にはならないかもしれない。
bl      0x1000004b4 <_rand+0x1000004b4>
mov     w8, #0x5556             ; =21846
movk    w8, #0x5555, lsl #16
smull   x8, w0, w8
lsr     x9, x8, #63
lsr     x8, x8, #32
add w8, w8, w9x8レジスタは64bitレジスタで、w8はその下位32bitにアクセスできるレジスタだ。順に命令とその結果を見ていく3。
- mov命令でw8レジスタが0x5556になる
- movk命令でw8レジスタの上位16bitが0x5555になる。つまりw8レジスタは0x55555556となる
- smull命令で
rand()関数の返値にw8レジスタが掛けられてx8レジスタに書き戻される - lsr命令でx8レジスタを64論理右シフトした結果をx9レジスタに書き込む
- lsr命令でx8レジスタを32論理右シフトした結果をx8レジスタに書き込む
- add命令でw8レジスタとw9レジスタを足し合わせた結果をw8レジスタに書き込む
一例として 43 / 3 を考えてみる。マジックナンバーは 0x55555556 であるから、
fn main() {
    let m: i32 = 0x5555_5556;
    let n: i32 = 42;
    let x = (m as i64) * (n as i64);
    let a = x >> 63;
    let b = x >> 32;
    let y = a + b;
    println!("{} / 3 = {}", n, y);  // 43 / 3 = 14
}
といった計算になる。このコードは 0x7fff_ffff / 3 といった大きな数の除算でも機能するが、負数では追加の考慮が必要になるのでこのままでは機能しない。
Footnotes
-
定数除算は乗算やビットシフトなどに変換されるが、変数除算は最適化できないので、CPUにおいてかなり遅い処理になる。 ↩
-
なぜ2次元のデータに対して3次元の行列が必要なのかについてはそのほうが便利だからである。変換用の行列は2次元でも定義できるものの、制約が発生することを確かめてみてほしい。 ↩
-
Jun’s Homepageの情報を参考にした。感謝。 ↩